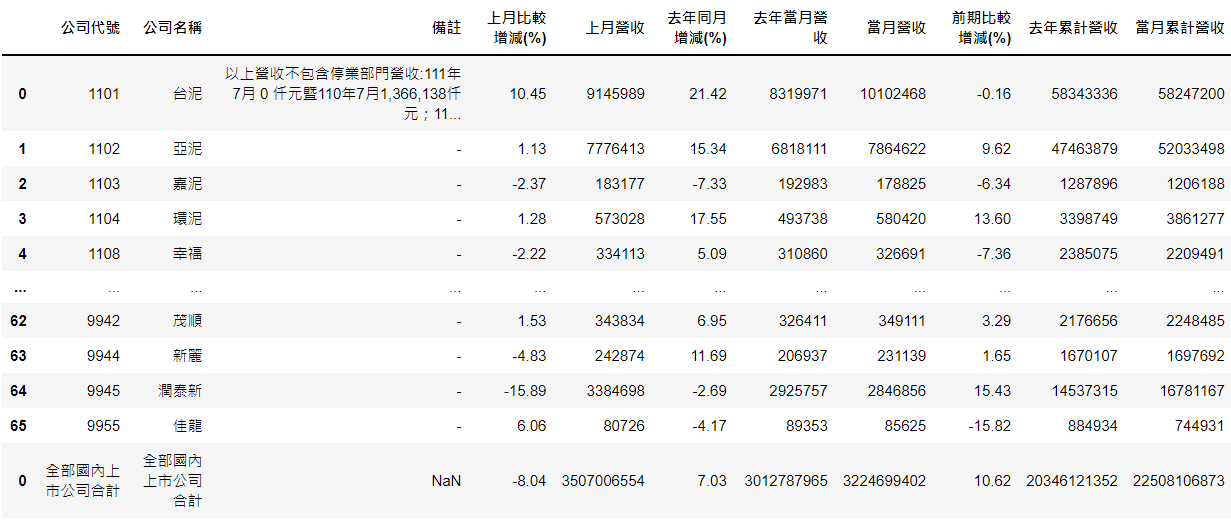
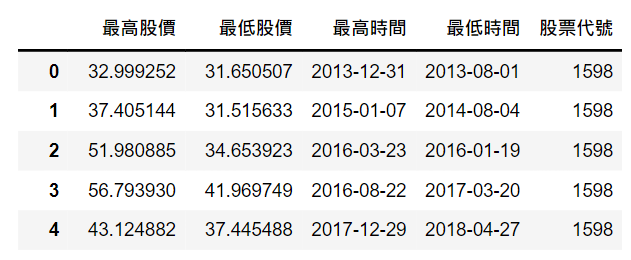
with pd.ExcelWriter('test.xlsx', engine='xlsxwriter') as writer: df.to_excel(writer, index=False, na_rep='NaN') for column in df: # 遍瀝每個欄位 column_width=10 if(column=='備註'): column_width = 100 col_idx = df.columns.get_loc(column) writer.sheets['Sheet1'].set_column(col_idx, col_idx, column_width) # 指定該欄位大小
再來是將有多個工作表的excel讀取
1
2
3
4
5
6
7
wb = openpyxl.load_workbook("goodMoM100.xlsx") test=[] file_name="goodMoM100.xlsx" size=wb.sheetnames # 得到所有工作表 for i in size: test.append(pd.read_excel(file_name, sheet_name=i,engine='openpyxl')) test[0] # 將會是第一個工作表的資料
最後是將多個df存成多個工作表。
1 2 3 4 5
# test會是多個dataframe sub_sheet=['你想要的工作表名字','.......'] with pd.ExcelWriter(f'singlehighMoM100.xlsx', engine='xlsxwriter') as writer: for i inrange(len(test)): test[i].to_excel(writer, sheet_name=sub_sheet[i])